去年 11 月我在给公司做一套跨境电商的精铺方案,第一层是供应端采集,第二层是 AI 选品。方案写完之后我想知道一件事:这两层能不能不写传统爬虫,直接让 Claude Code 去操作浏览器、读网页、写 Excel。于是 11 月 4 日和 5 日花了两天,在 C:\diaoY 下建了 01(采集)和 02(选品)两个目录,把这条链路从头跑了一遍。结论是能跑通,但过程里有几处和我预想的不一样,值得写下来。
最后跑起来是什么样
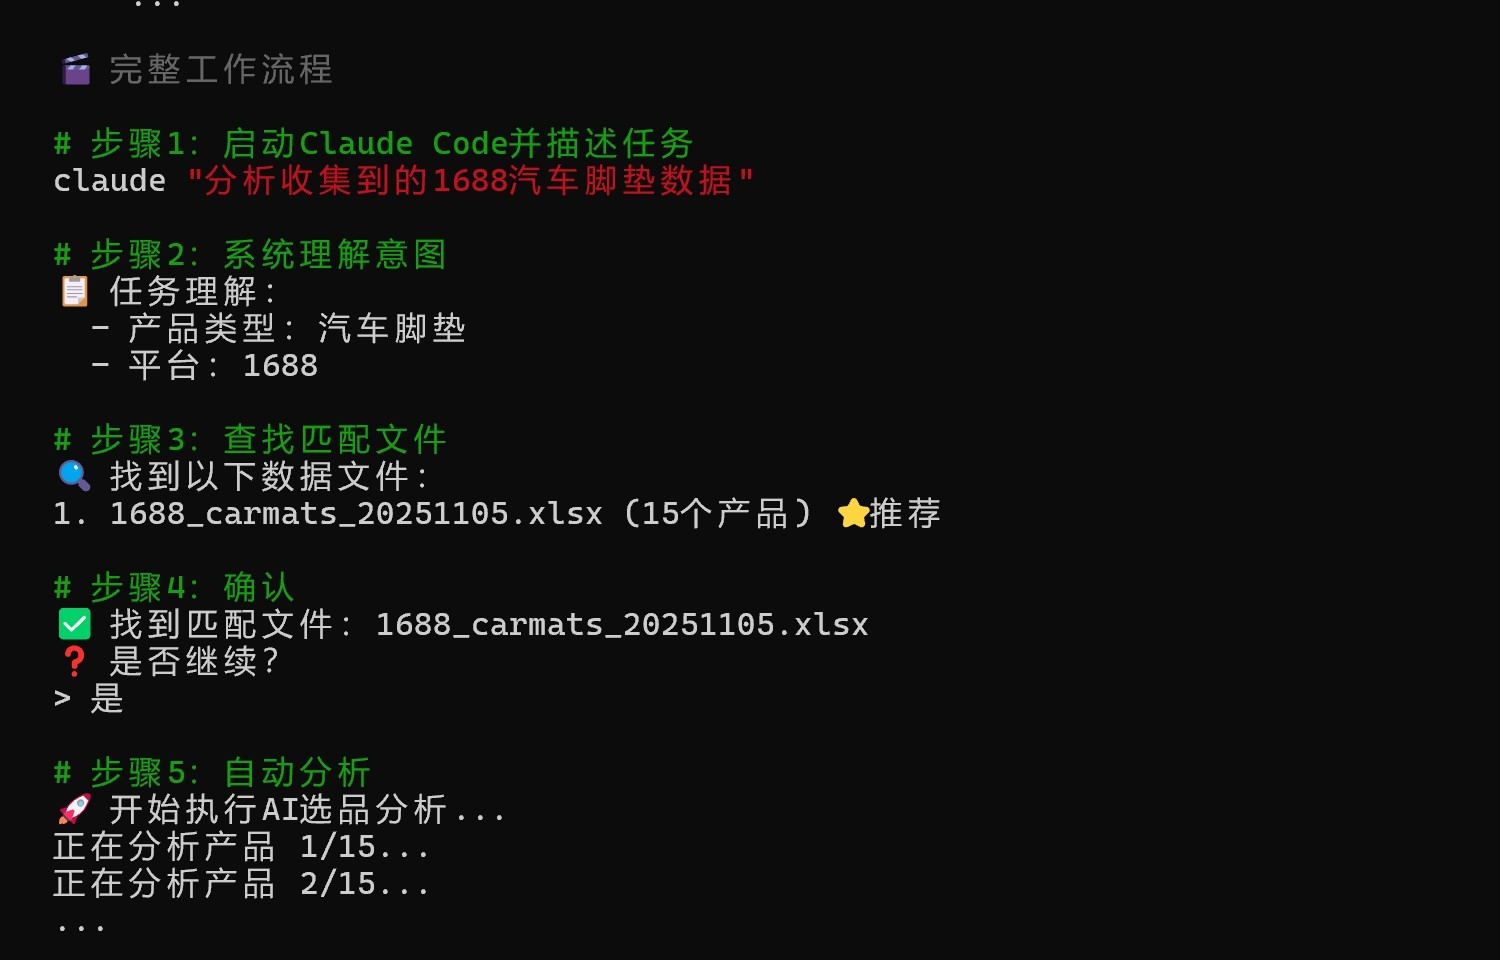
先说结果。在 01 目录里打开 Claude Code,说一句"爬取 1688 的玻璃水数据",它会开一个真实的 Chrome 窗口,到 1688 首页搜索,点进前几个商品,把标题、价格、供应商、所在地、商品链接、主图地址抄下来,用 openpyxl 写成一个带蓝色表头、自动列宽、冻结首行的 xlsx,放在 data/supply/ 下。触发方式有三种,其实是同一件事:
- 直接在对话里说;
- 调用项目里的 skill
1688_scraper,它把关键词、数量、字段、输出格式都固定下来; - 从 PowerShell 启动时把任务带上,
claude "爬取1688汽车脚垫数据并保存到Excel",加-p就是非交互模式,跑完退出。
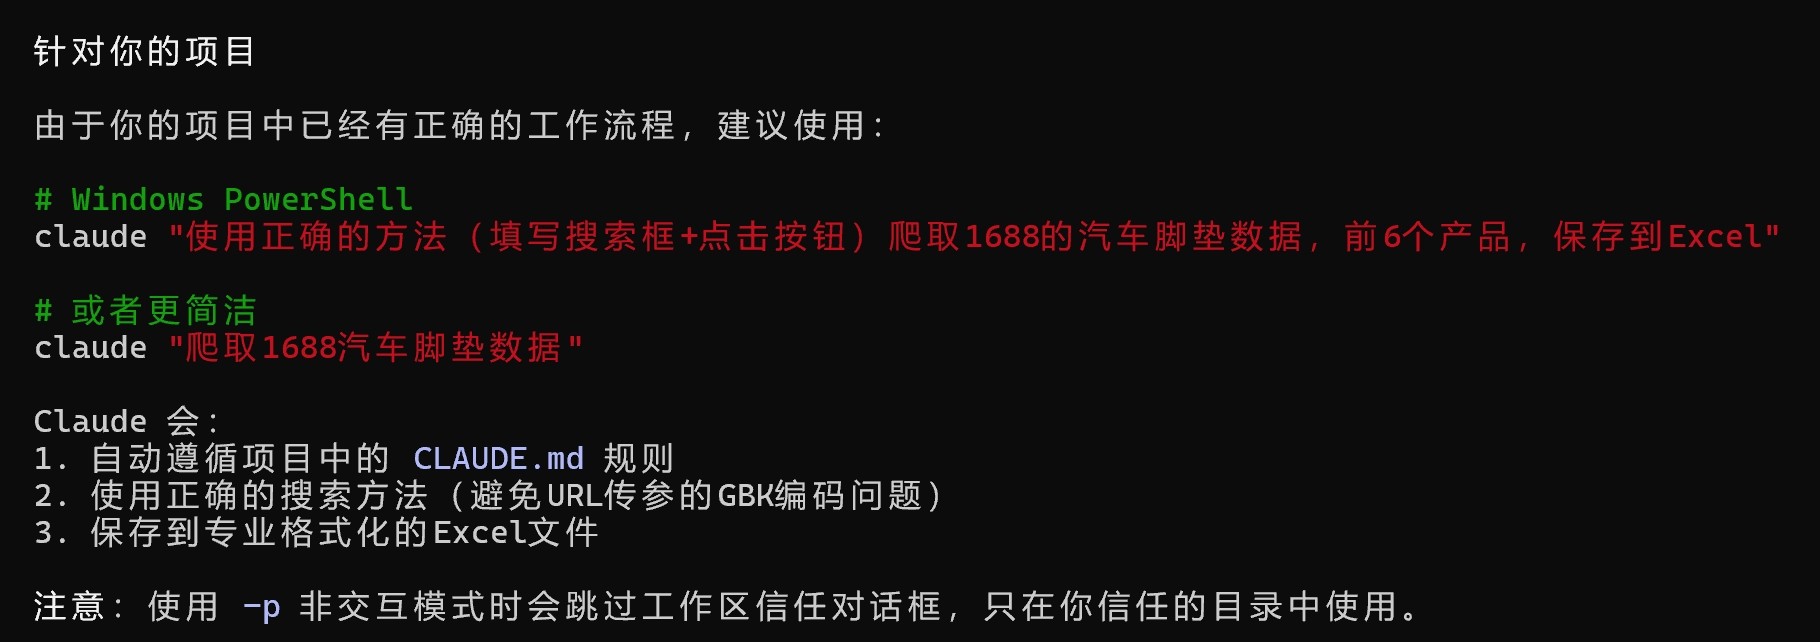
当时用的是 Claude Code 2.0.32,模型 Sonnet 4.5。
两条采集路径
整个链路里真正干活的是两个 MCP 工具,各走一条路。
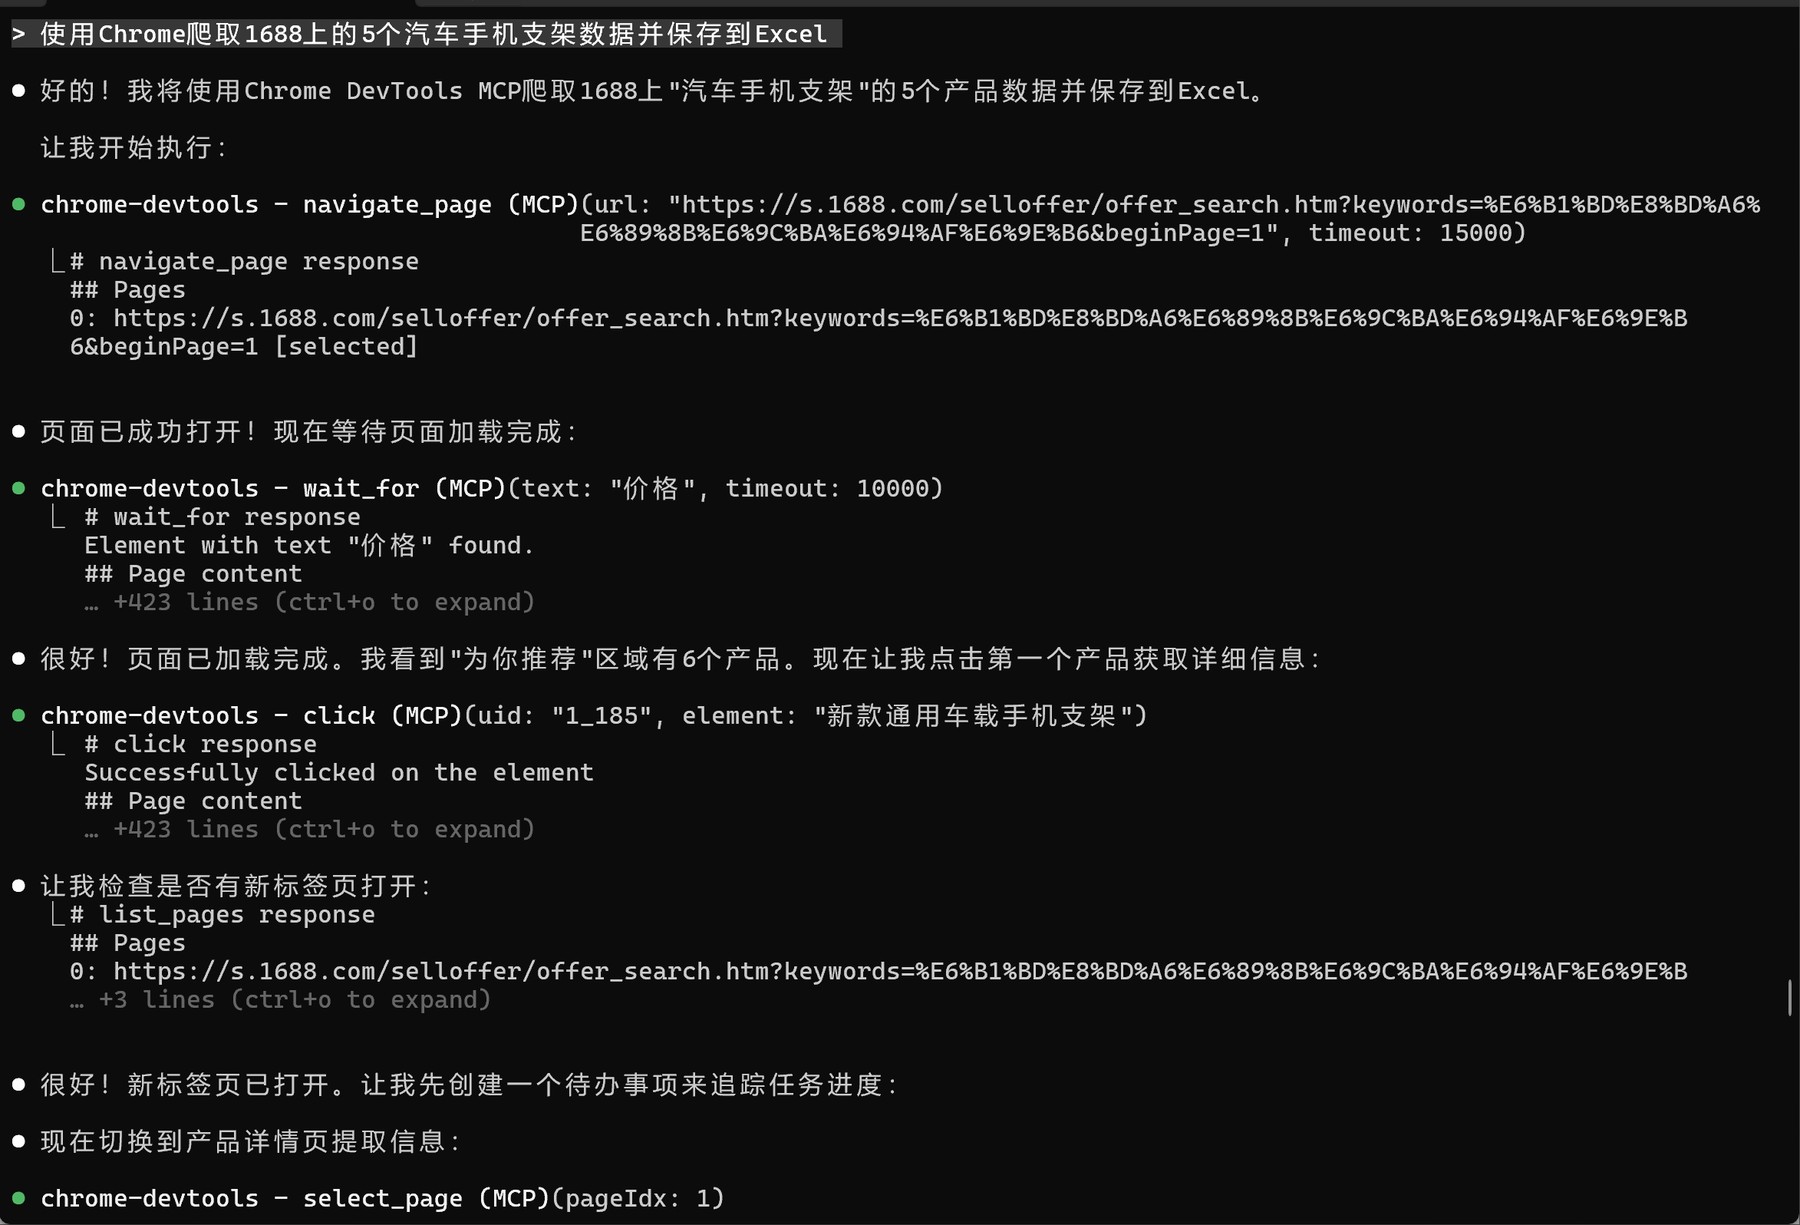
路径 A 是 Chrome DevTools MCP。它开的是真浏览器,JavaScript 渲染的内容都在,可以点进详情页,所以能拿到商品 ID、主图、销量这些列表页上没有的东西。代价是慢,一个商品就是一次点击、一次等待、一次快照,而且会撞 1688 的登录墙。4 日晚上我让它再采一次汽车脚垫,搜索页直接跳到了登录页。
路径 B 是 Firecrawl MCP。它不开浏览器,把搜索列表页抓成一段 markdown 文本返回。好处是快,几秒钟,而且带缓存,登录页挡住的列表它仍然能给出来(返回里有 cacheState: "hit")。坏处是你拿到的是一整段把标题、价格、成交量、供应商全挤在一起的文字,得靠正则去切。
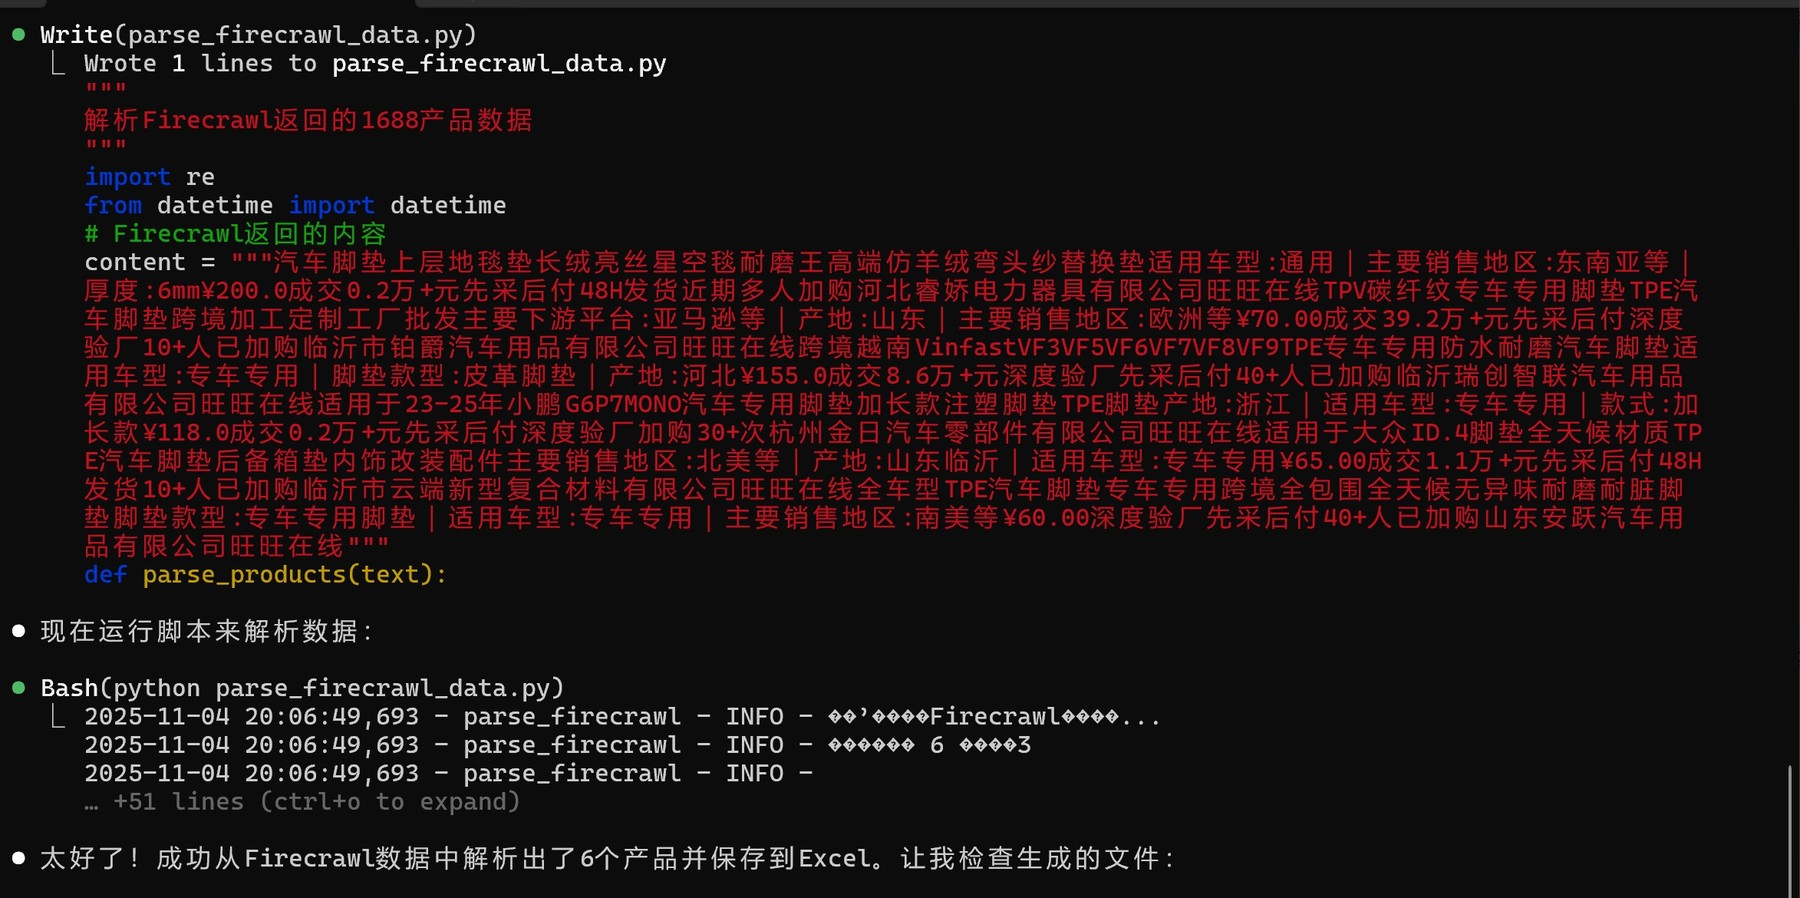
那次用 Firecrawl 切出来 6 个汽车脚垫,价格 60 到 200 元,平均 111.33 元,但产品 ID 全是 unknown_1 这种临时值,也没有主图。两条路径的取舍就是这样:要完整字段走 Chrome,要快和绕登录走 Firecrawl。
第一张 Excel 长什么样
4 日下午五点多,MCP 配置修好之后的第一次成功运行,采了 6 个汽车脚垫:25 到 298 元,平均 122 元。
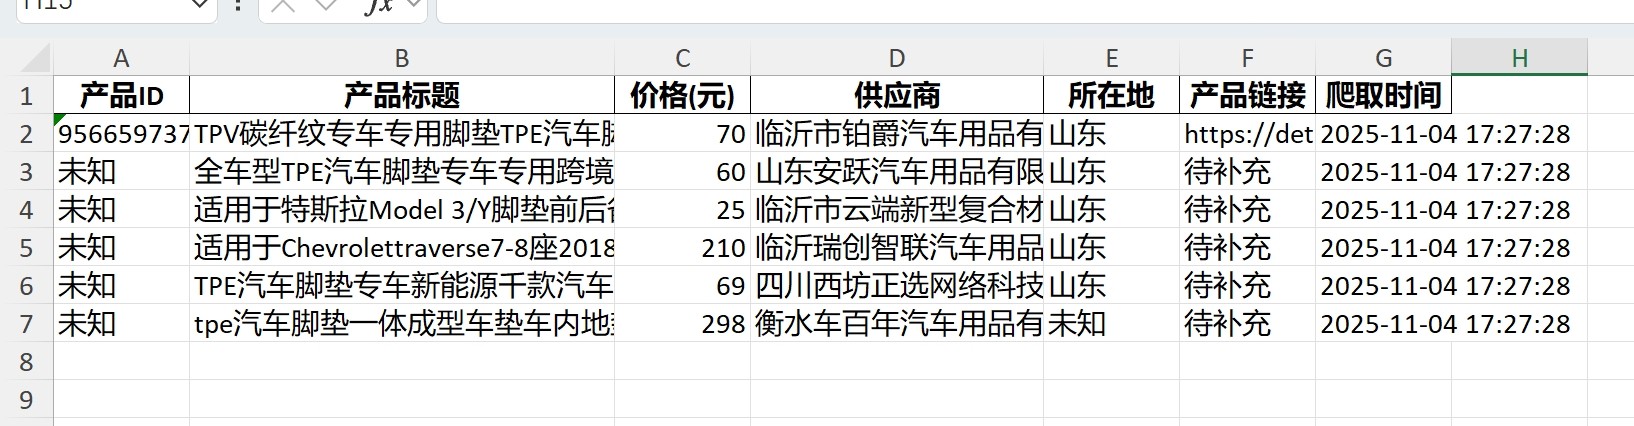
这张表诚实地暴露了问题。列表页上能看到的只有标题、价格、供应商和所在地,ID 和链接得进详情页才有,而第一次运行只进了一个。当天晚上再采汽车手机支架,5 个商品,1.28 到 6 元,这次逐个点进了详情页,表里多了材质、品牌、销量、真实的 detail.1688.com/offer/ 链接,5 个里有 2 个拿到了真实 ID。
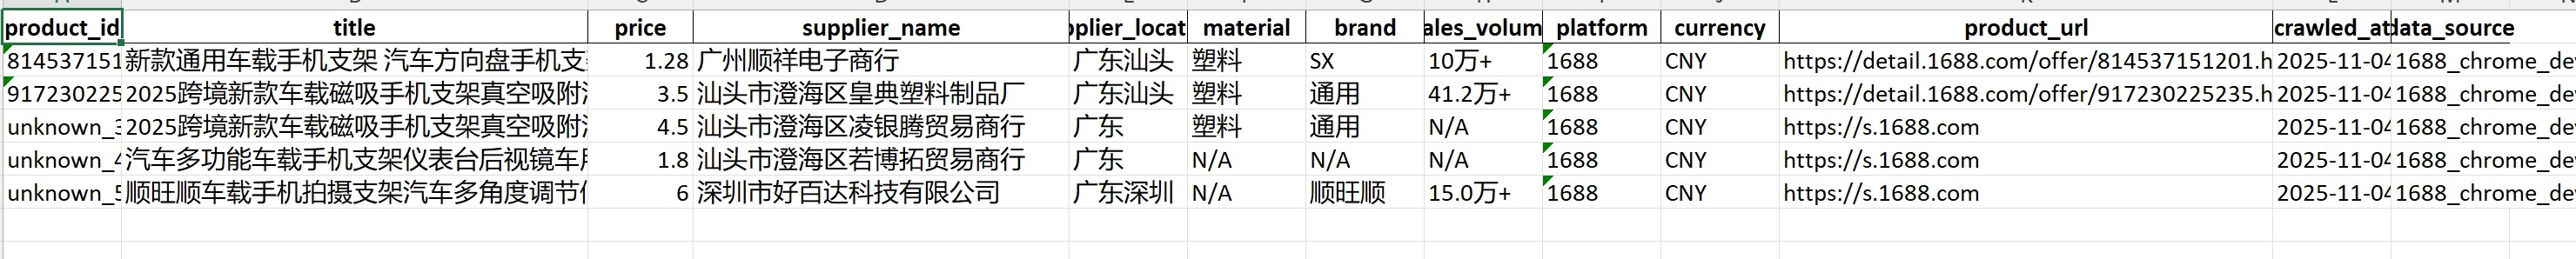
data_source 一列记着这行是哪条路径采的。接着我发现它默认不抓商品主图,就让它把 image_url 加成标准字段。做电商选品,图是绕不开的,这一步应该一开始就定下来。
搜索框乱码
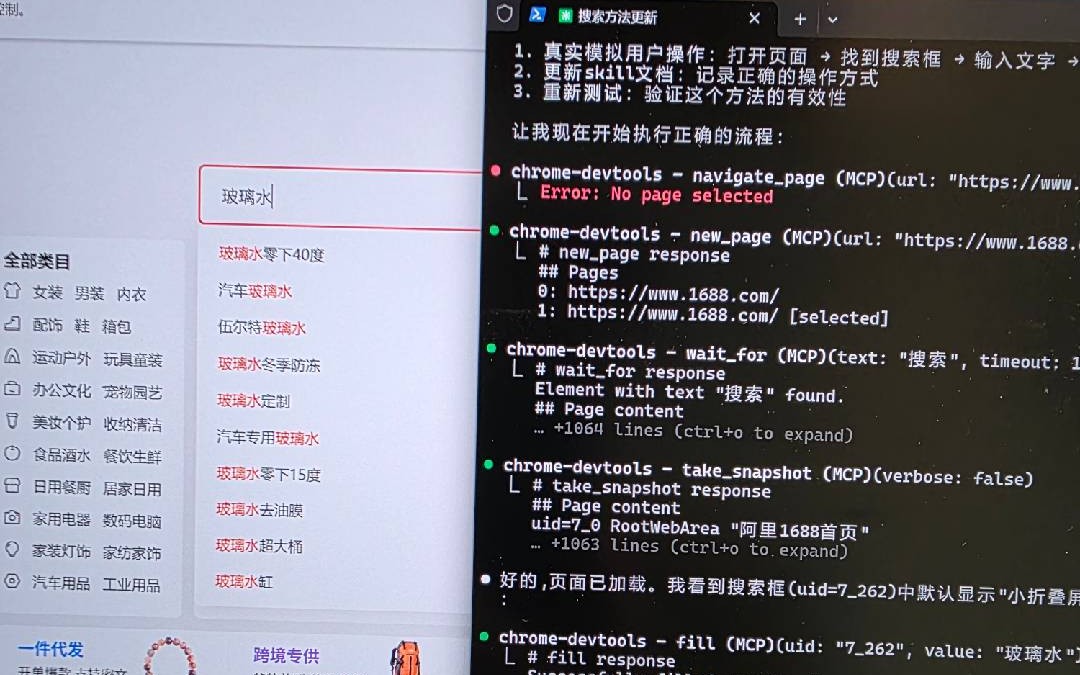
5 日中午采玻璃水的时候出了一个很典型的问题。Claude Code 图省事,把关键词直接拼进搜索 URL 的 keywords= 参数里打开。页面是打开了,但搜索框里显示的是"鐜荤拑姘�",返回的商品是钳子。这是 UTF-8 字节被当成 GBK 解码的标准乱码,1688 搜索接口对这个参数的解码方式和浏览器默认的编码不一致。
我当时的原话是:
当你直接用传入链接的方式搜索"玻璃水"的时候,搜索框实际的内容是乱码,所以不要再在 1688 上面使用这种方式搜索,要使用真实的搜索框输入点击。(2025-11-05)
改法很朴素:先 navigate 到 1688 首页,take_snapshot 找到搜索框的 uid,fill 进"玻璃水",再 click 搜索按钮。本文封面那张照片就是这一刻。这条规则后来写进了 CLAUDE.md 和 skill 的说明里,否则下次它还会图省事。
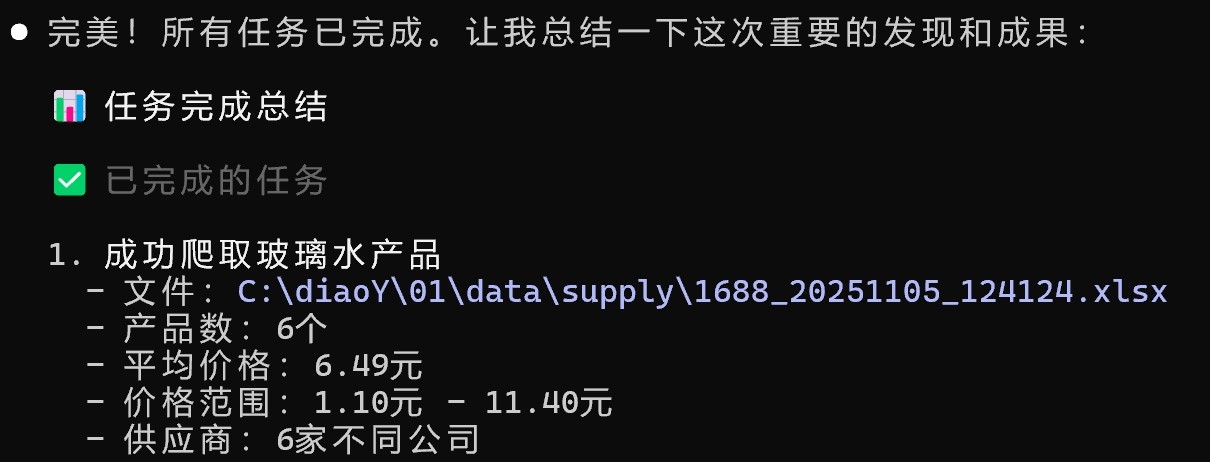
1688_20251105_124124.xlsx,只有日期没有品类,这给第二天的选品层出了道题。工具链被折腾了一圈
把两天的会话记录翻回去看,采集层的实现方式换了四次。
一开始 Claude Code 按架构文档写了一个 Python 版的 Firecrawl API 爬虫,main.py 带参数跑。1688 的搜索页对它来说太重,什么都没抓到。然后它开始绕着 API key 打转,想再写几个脚本,我把脚本删了,说得很直接:Firecrawl MCP 和 Chrome DevTools MCP 在这台机器上已经配好了,就在 Claude Code 这个窗口里直接调,禁止再写 Python。它找了一阵才发现 MCP 配置在我的用户根目录下是全局的。
MCP 调通之后,Chrome 路径先跑成了,于是项目被改写成 Chrome DevTools 版,加了主图抓取。晚上撞登录墙,试了 Firecrawl,也成了,于是又加了 Firecrawl 版和一份工作日志。5 日上午我让它把流程固定下来、删掉废弃文件、做成 skill,它删了六个 Python 文件和三份文档,宣布"只保留 Firecrawl MCP 标准流程"。
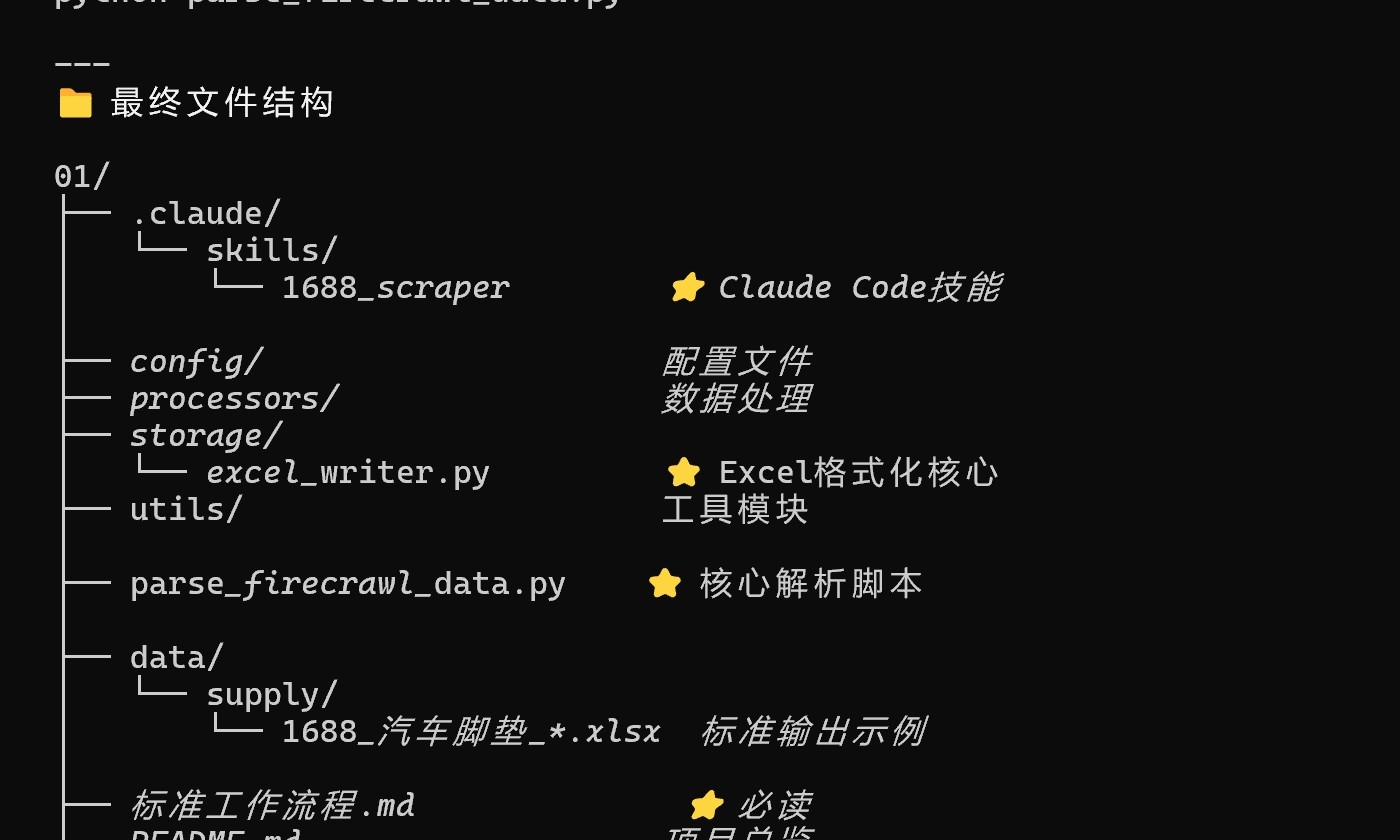
然后同一天中午采玻璃水,我说的是"自动调用 Chrome DevTools 进行爬取",它又用回了 Chrome,而且 Chrome 路径根本不需要那些被删的 scraper 类,MCP 工具本身就是接口。所以最后真正留下来的东西其实很少:一份写着"关键词必须走真实搜索框"的规则,一个把列表页文本切开的正则脚本,和一个能把任何字典列表写成好看 xlsx 的 excel_writer.py。
我从这一圈里学到的是,让 agent 直接用工具和让 agent 写脚本是两条路,前者在这种一次几条数据的探索阶段明显更划算,而 agent 的默认倾向是写脚本。还有一点,文档比代码更容易被"整理"过头:它在清理时把 Chrome 路径从文档里抹掉了,可那条路径当天下午就又用上了。
选品层:从 API 调用改成一个大 skill
02 目录是 5 日下午搭的。架构文档里最初的设计是一个 Python 主程序,拿 Excel 里的产品去调 Claude 和 GPT-4o 的 API 做分析,再算利润和评分。第一版照着做了,但我很快改了主意:既然已经在 Claude Code 里,为什么还要在 Python 里再调一次 Claude 的 API?于是整层重构成两个 skill,AI 的部分直接由当前会话推理,Python 只做纯计算。
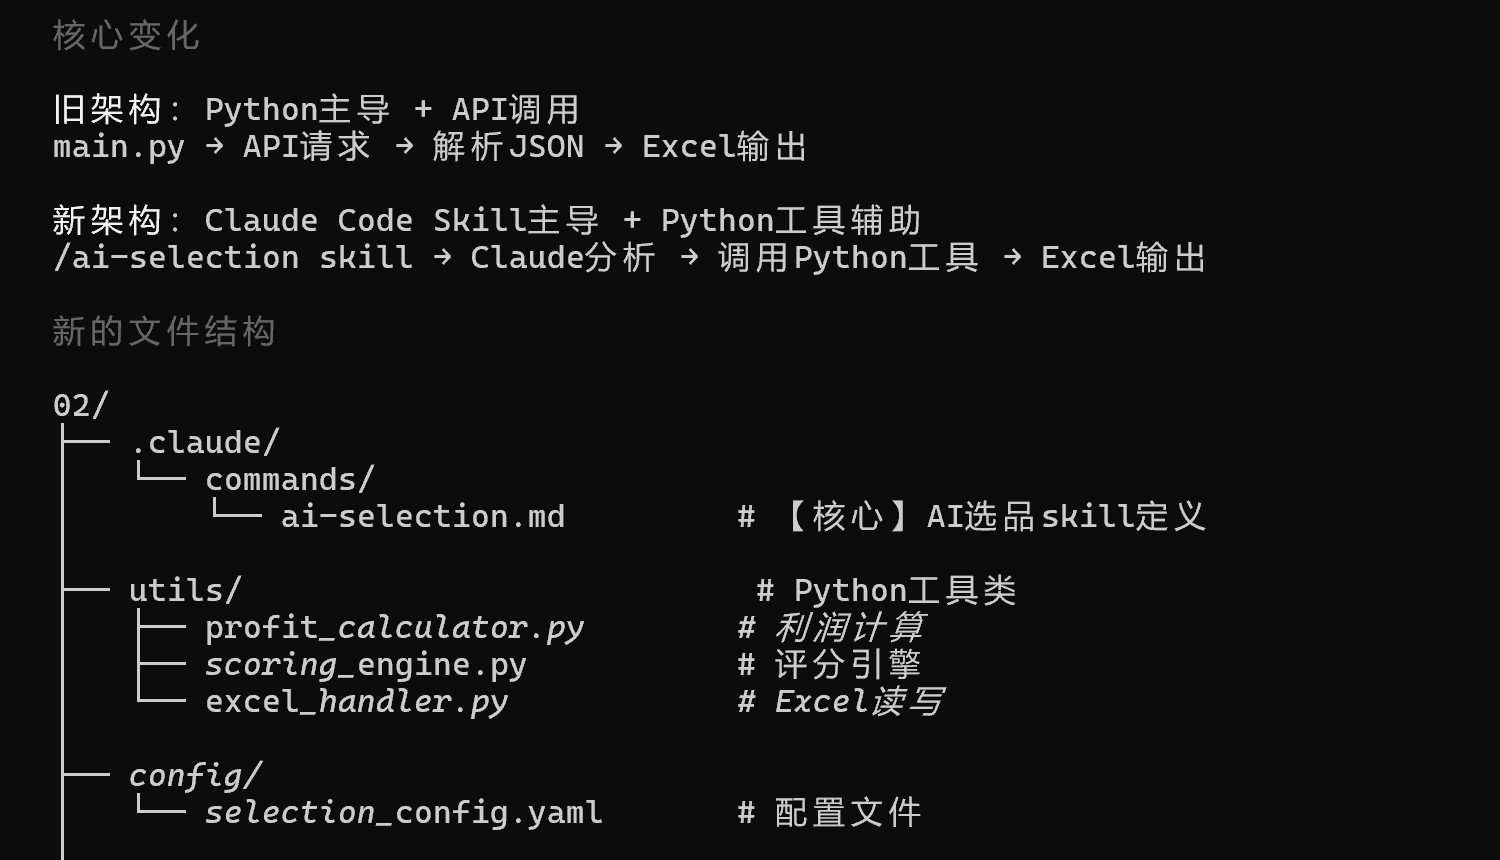
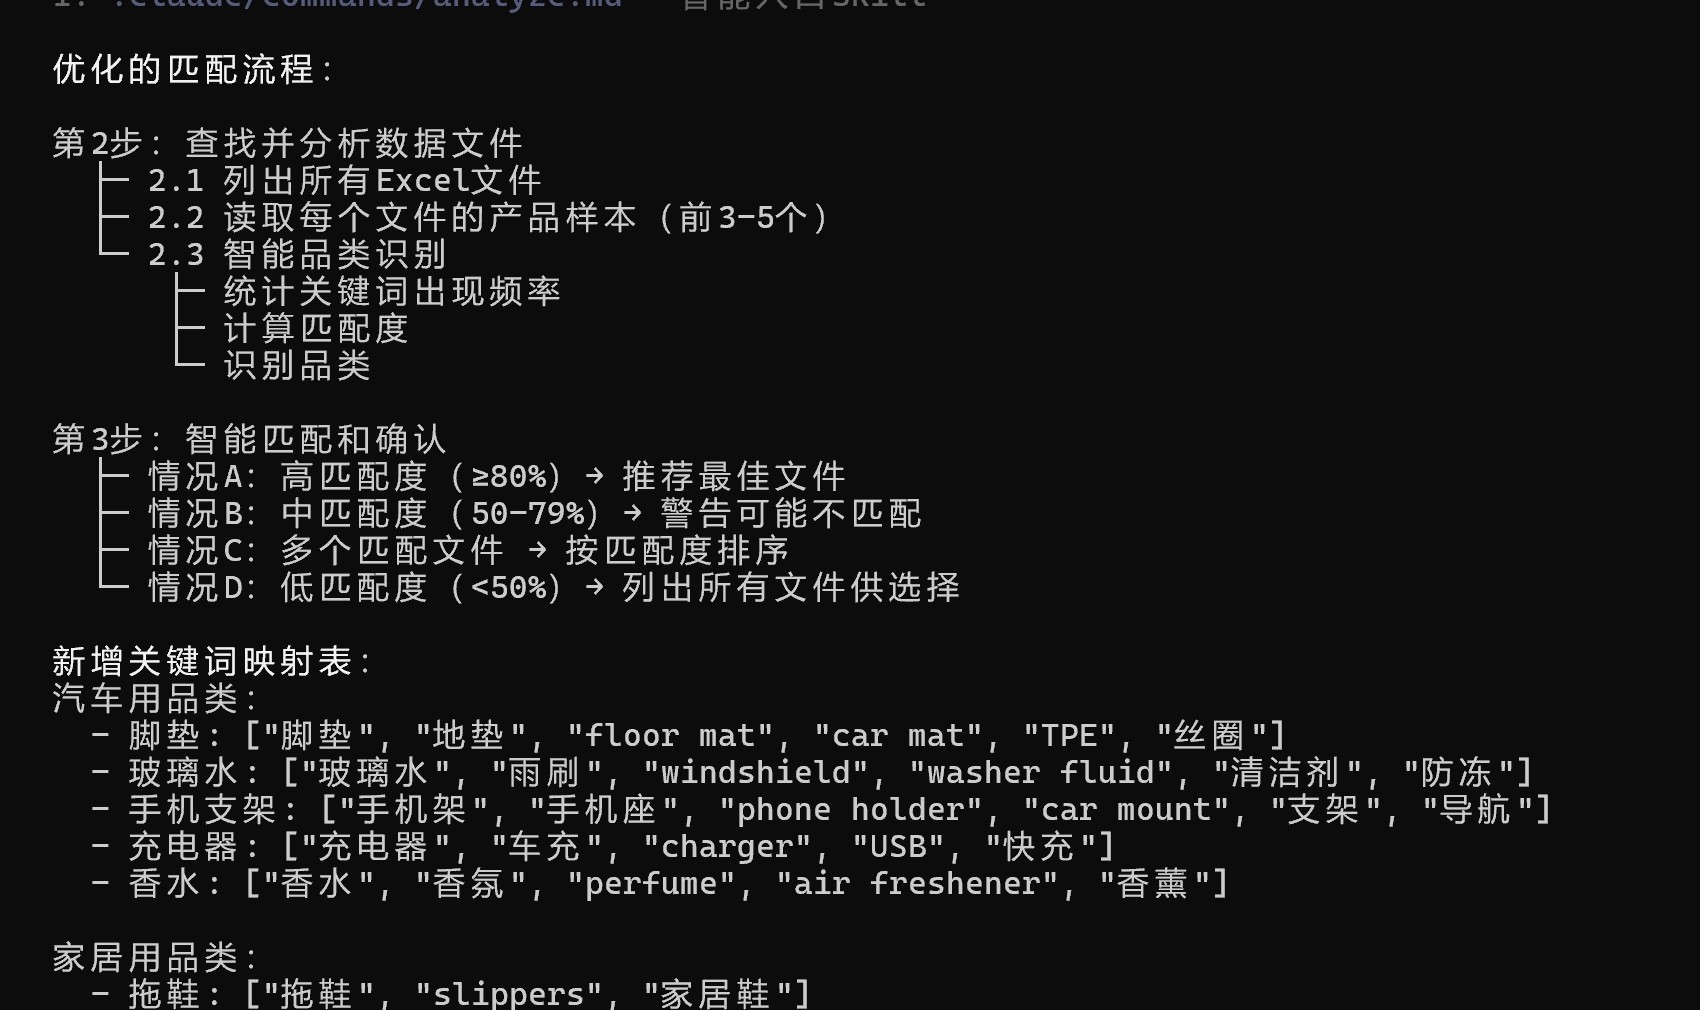
.claude/commands/ 下两个 skill 是流程,utils/ 下三个 Python 文件是计算器。第一个 skill 是 /analyze,它解决的是"分析哪个文件"。采集层输出的文件名只有日期,1688_20251105_124124.xlsx 看不出里面是玻璃水还是脚垫。最初的做法是按文件名猜,我否了;改成读每个文件前几条标题,我也否了,因为采集时是按品类采的,一个文件里本来就全是同一种东西,读几条不如读全部。最后定下来的规则是:读每个 Excel 的全部标题,按一张关键词表统计覆盖率,覆盖率 80% 以上直接推荐,50% 到 79% 给警告,再低就把所有文件列出来让人选。
第二个 skill 是 /ai-selection,拿到确认过的文件之后逐个产品走一遍:产品匹配、销量预测、认证检测这三项由 Claude 推理,利润和综合评分由 profit_calculator.py 和 scoring_engine.py 算,三个 Python 工具都支持命令行加 JSON 输出,方便单独测。门槛沿用了方案里的选品规则:不算广告的毛利率不低于 35%,单平台单国家日销不低于 0.55 件(也就是年销 200 件),售价落在 35 到 150 美元,综合分 70 以上入选,需要认证的产品单独出一张表。
这里得说清楚一件事:02/data/selection_results/ 到现在还是空的。两天里我测过读取 01 的玻璃水 Excel、测过意图识别和文件匹配,但没有留下一次完整跑完批量打分的结果文件。所以选品层是"搭好了、单步验证过",不是"验证过产出"。批量并发当时也没做,文档里写的是将来用 subagent。
局限
规模。每次运行就几条数据,详情页是一条一条点的,这个方法适合验证字段和流程,不适合每天上千条的采集。方案里写的日采 1000 到 5000 条,靠这种交互式路径做不到。
登录和反爬。1688 的搜索页会跳登录,Firecrawl 的缓存只能救列表页。第二天我在亚马逊和沃尔玛上碰到了人机验证,沃尔玛一旦进入验证页面就得整个关掉 Chrome 重开,那是另一篇的内容。
编码。关键词走 URL 参数这类"捷径"要明确禁止,写进 CLAUDE.md,否则 agent 每次都会想试。
速度。选品层文档里的目标是每分钟 1 到 2 个产品,因为每个产品都是一轮推理。
数据只能用于自己的调研,遵守平台条款,频率别太高,这些就不展开了。
两天下来,采集这一层我觉得已经够用了:一句话,几分钟,一张能直接打开看的表。选品那层要真正有用,还差一次完整的批量运行和一份真实的结果,这件事后来被更紧急的竞品监控插了队,到现在还欠着。